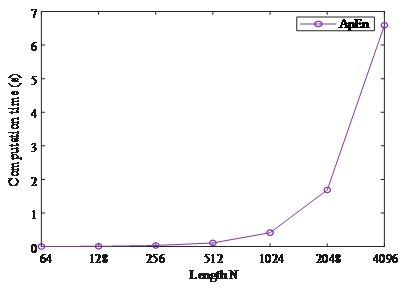
近似熵(Approximate Entropy)
基本原理
给定长度为 \(\left\{ {x\left( i \right),i = 1,2, \cdots ,N} \right\}\) 的时间序列 \(\left\{ {x\left( i \right),i = 1,2, \cdots ,N} \right\}\),近似熵的计算步骤如下:
对 \(X\) 重构相空间,嵌入维度为 \(m\) ,形成 \(m\) 维的向量序列:,可以表示为:
定义 \(d\left[ {X\left( i \right),X\left( j \right)} \right]\) 是向量 \(X\left( i \right)\) 和 \(X\left( j \right)\) 的切比雪夫距离,即两个向量对应元素之间差值绝对值的最大值:
对于 \(X\left( i \right),1 \le i \le N - m + 1\),需要计算其与剩余其他向量 \(X\left( j \right),1 \le j \le N,j \ne i\) 之间的 \(d\left[ {X\left( i \right),X\left( j \right)} \right]\)。因此对任意 \(X\left( i \right)\) 都有 \(N - m\) 个距离 。
给定阈值 \(r\) ,对于所有的 \(X\left( i \right)\) ,统计 \(d\left[ {X\left( i \right),X\left( j \right)} \right]\) 中小于阈值 \(r\) 的数量,然后这个数量与总距离数 \(N - m\) 的比值记为:
对 \(C_i^m\left( r \right)\) 取对数,然后计算所有 \(N - m + 1\) 个 的均值,记为:
将嵌入维度增加到 \(m + 1\),重复以上步骤1-步骤4,得到 \(C_i^{m + 1}\left( r \right)\) 和 \({\phi ^{m + 1}}\left( r \right)\)。
理论上,近似熵可以被计算为:
由于实际信号的 不能趋近于无穷大,有限序列的近似熵定义为:
备注
This is a note admonition. 近似熵是由Pincus[1]提出的,建议的参数选择为:
嵌入维度 \(m=2\)
容限 \(r\) 一般取 0.1~0.2 倍时间序列的标准差(SD)。在后续的仿真验证中,我们选择 \(r = 0.15 \times {\rm{SD}}\) 。
代码实现
这里假设您已经获得本项目的的所有代码,若您此时还未获得有关程序,请移步到 安装说明
近似熵(Approximate Entropy)的核心程序为 ApproximateEntropy
function AE=ApproximateEntropy(data,m,r)  % 输入的时间序列data为列向量即可
    AE=ApproximateEntropy1(data,m,r);
end
仿真验证
近似熵的脉冲检测结果
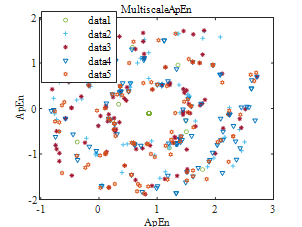
多尺度近似熵的故障分类可视化结果